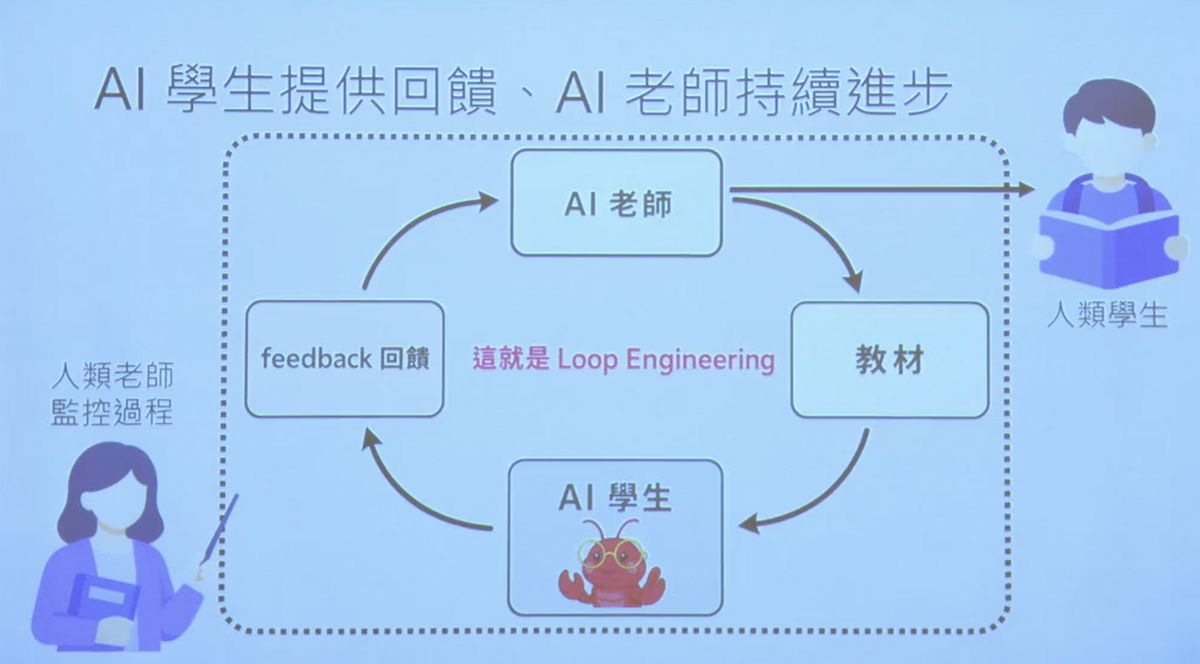
1.1它只做一件事:文字接龙
结论
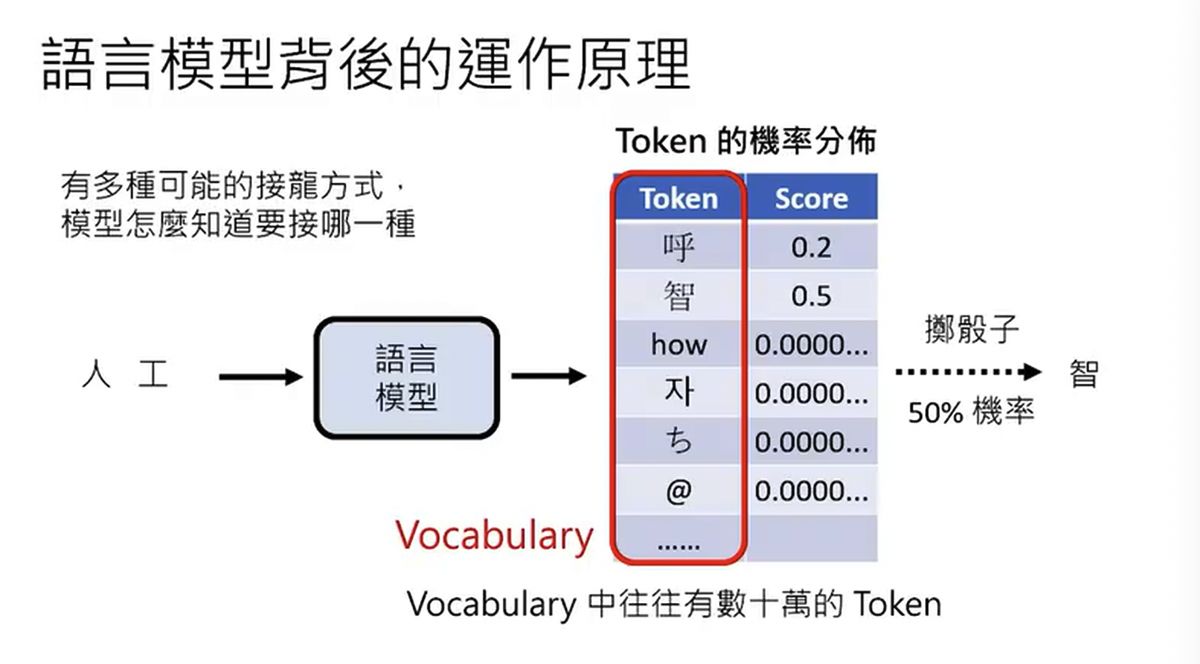
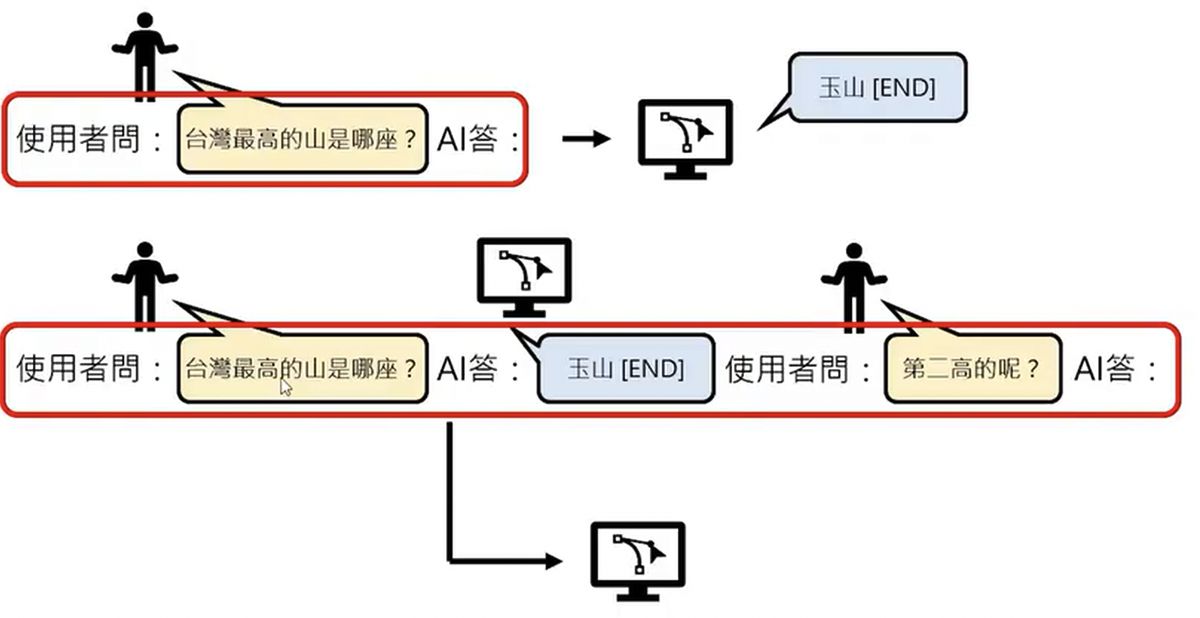
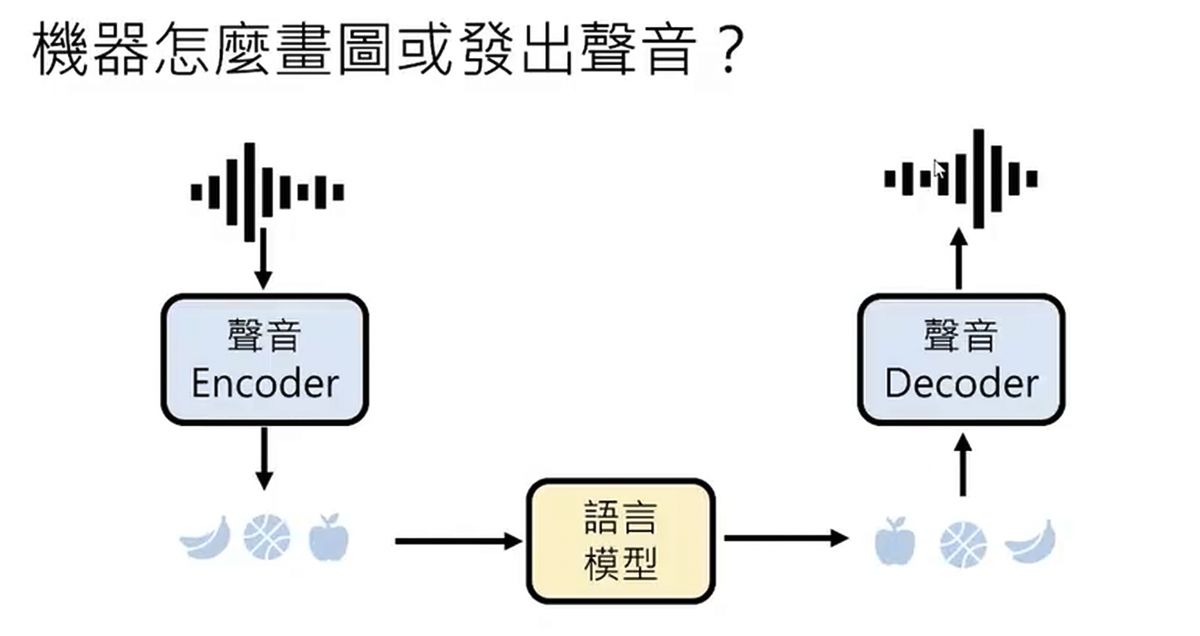
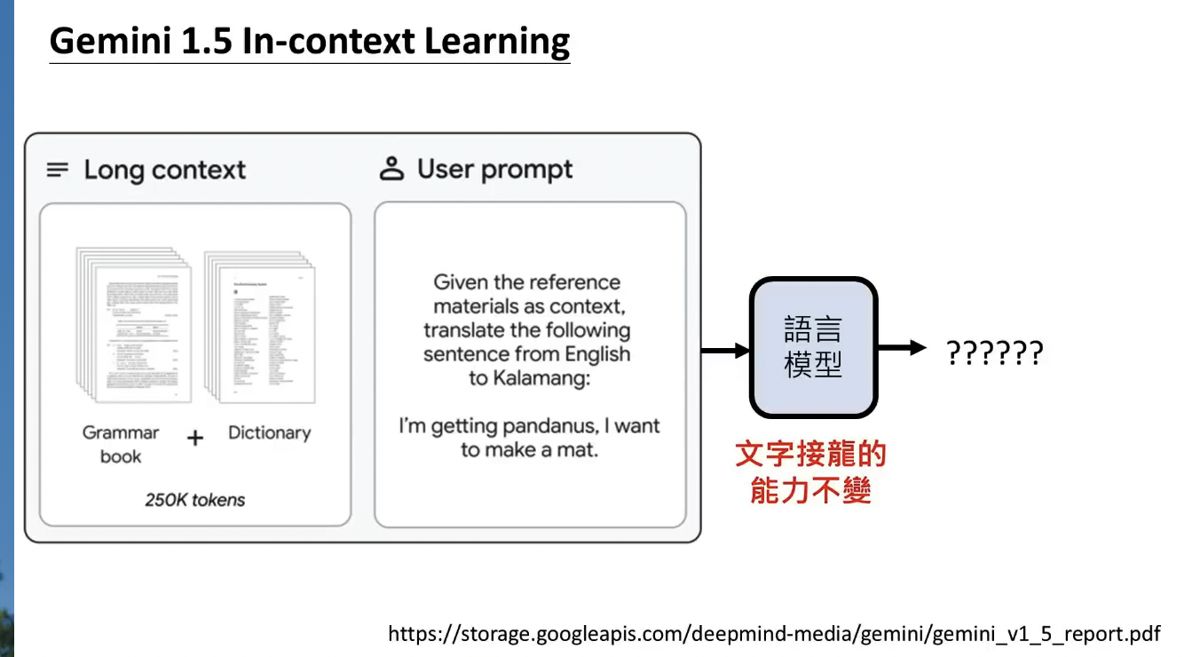
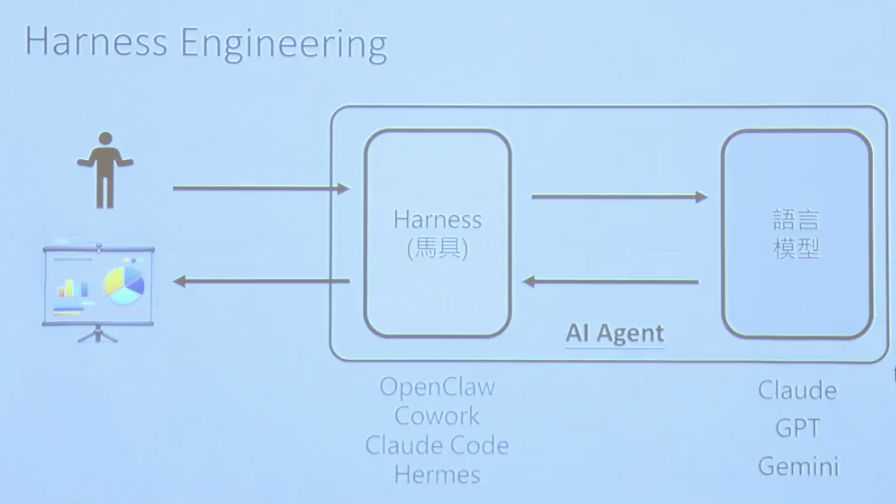
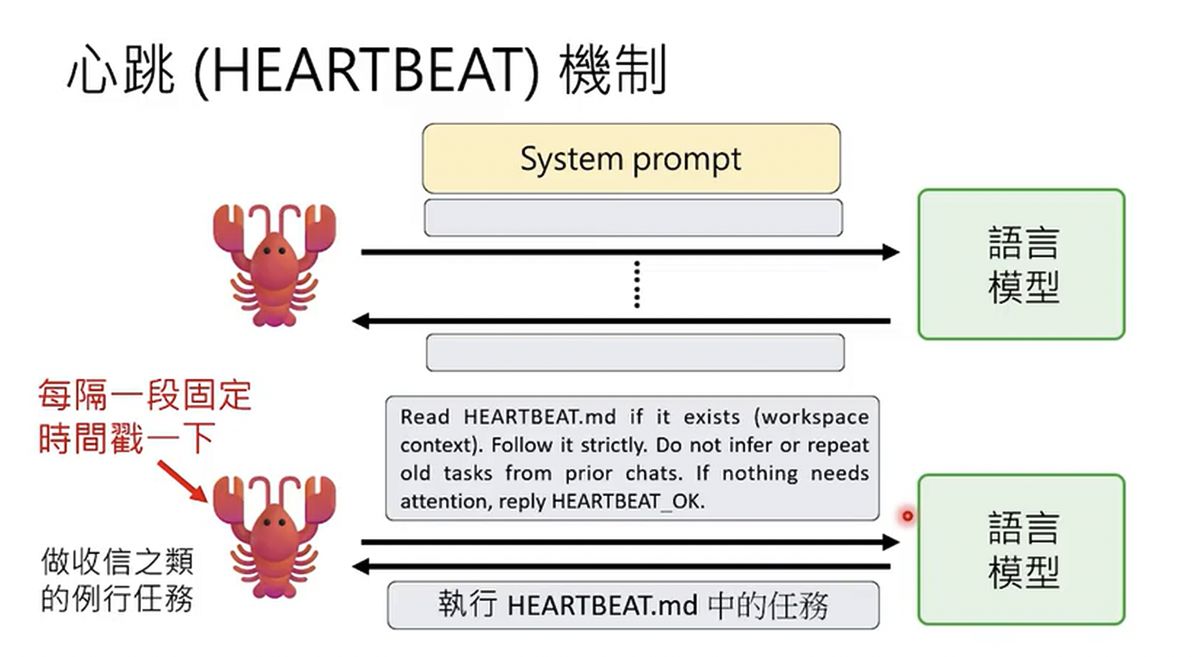
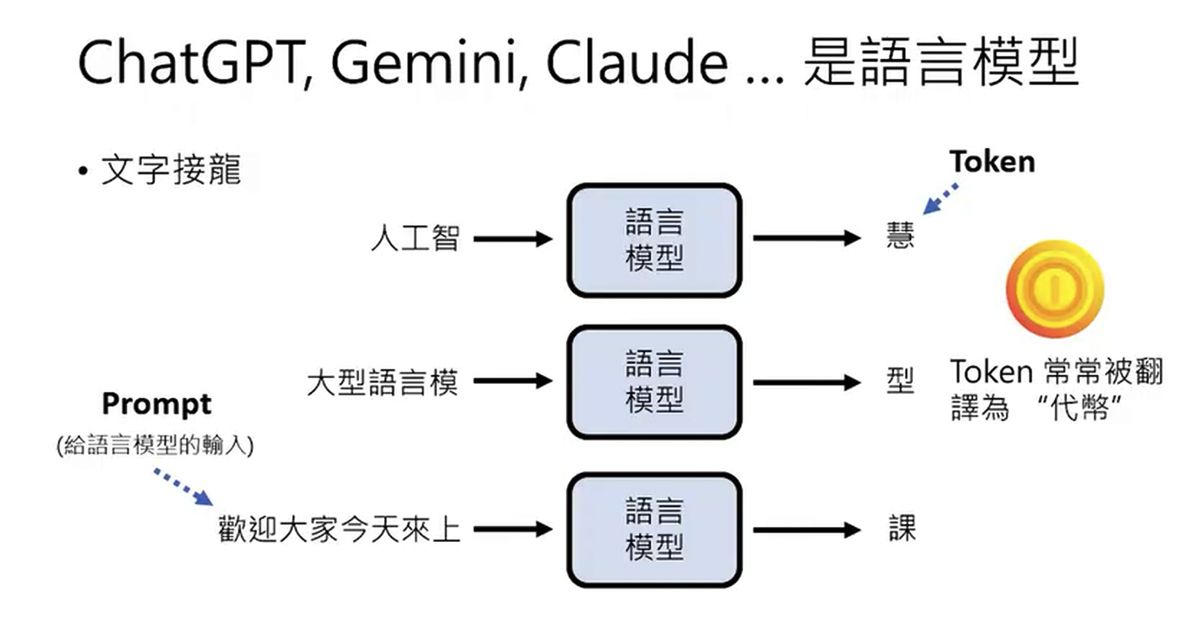
不管是聊天、写文章还是解题,大模型每一步只做一件事:看前面的文字,猜下一个 token,接上去,再猜下一个,直到接出「结束」符号为止。
不知道会踩的坑
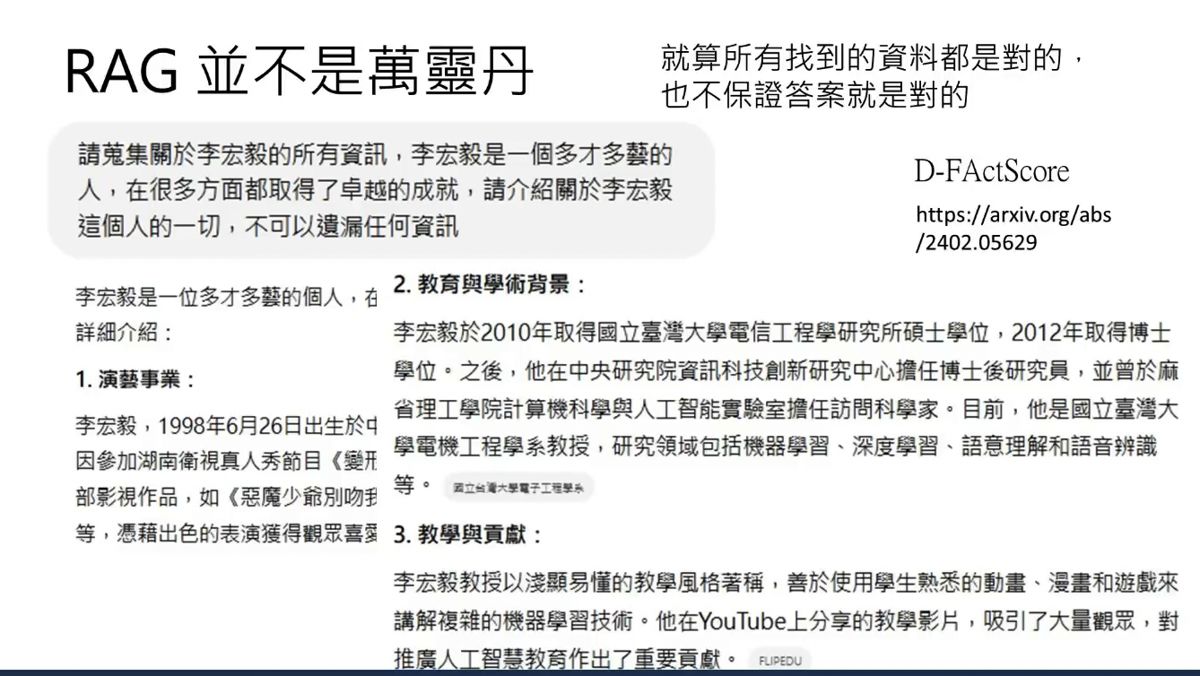
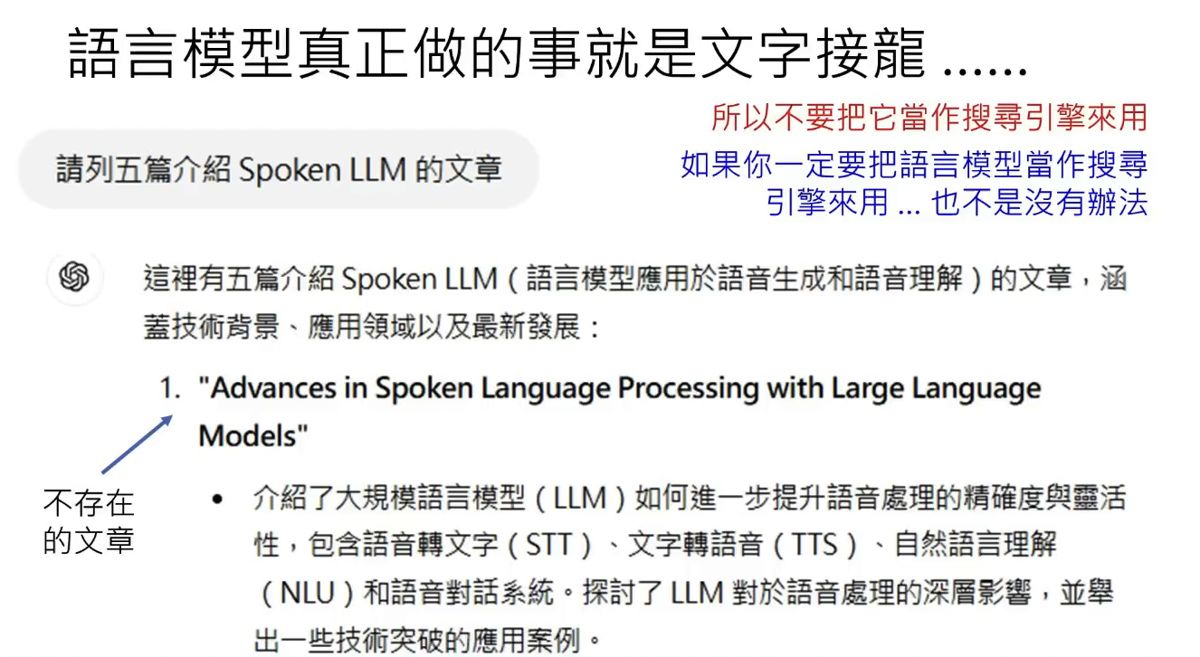
把它当成查资料的搜索引擎,或当成懂你的人。前者让人全信它的话,后者让人对它的错误莫名其妙。
李宏毅怎么讲
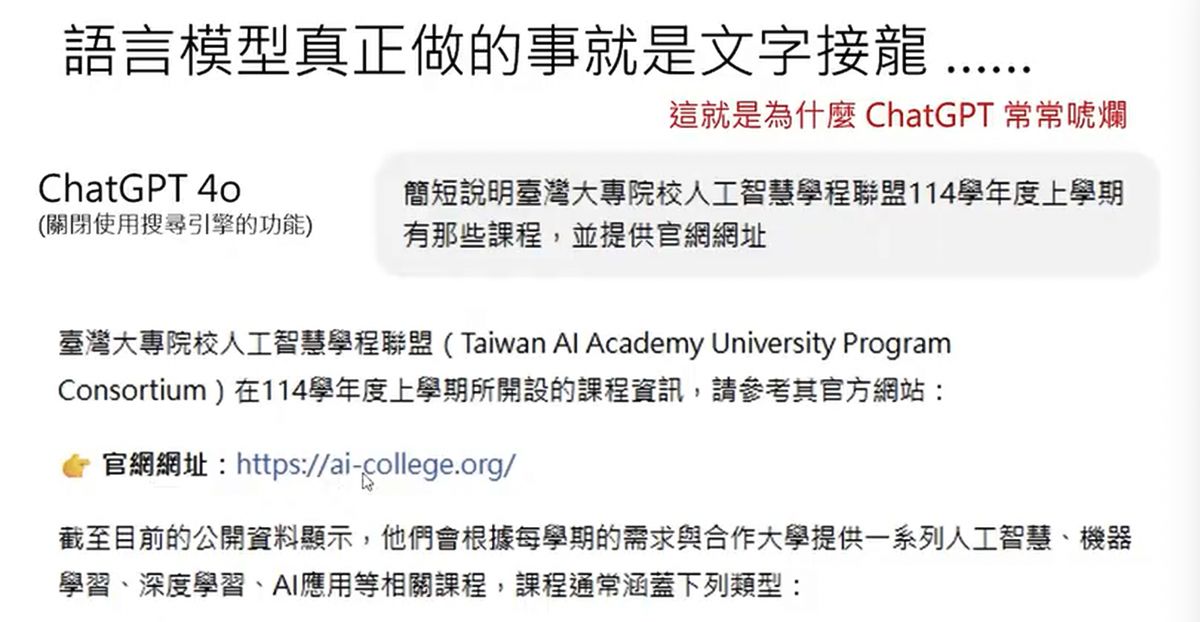
ChatGPT 这一类人工智慧,真正会做的事情,就只有一件事,就是文字接龙。你给它一个未完成的句子,它会去猜说,这个未完成的句子后面可以接哪一个字。
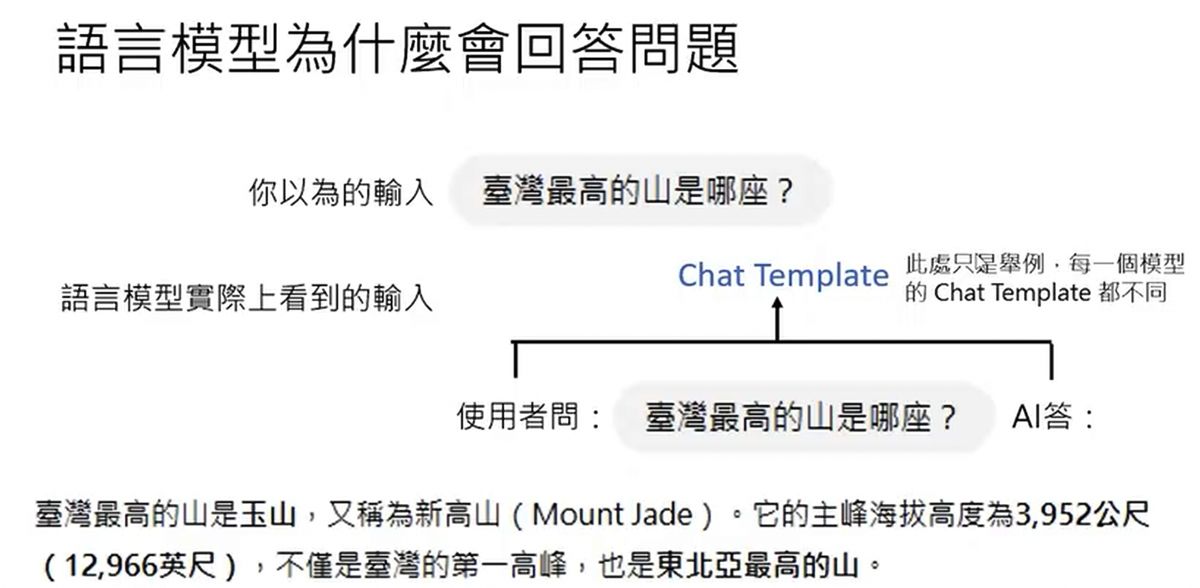
(《一堂课搞懂》§ChatGPT 真正会做的事情,只有一件事)- 回答问题也是接龙:
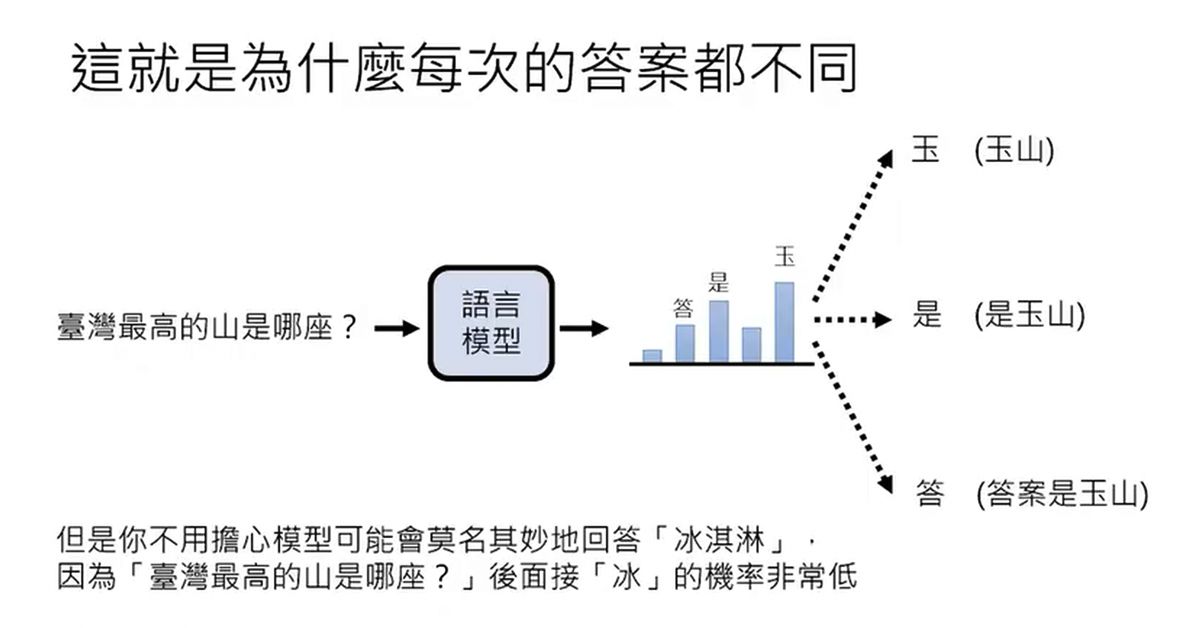
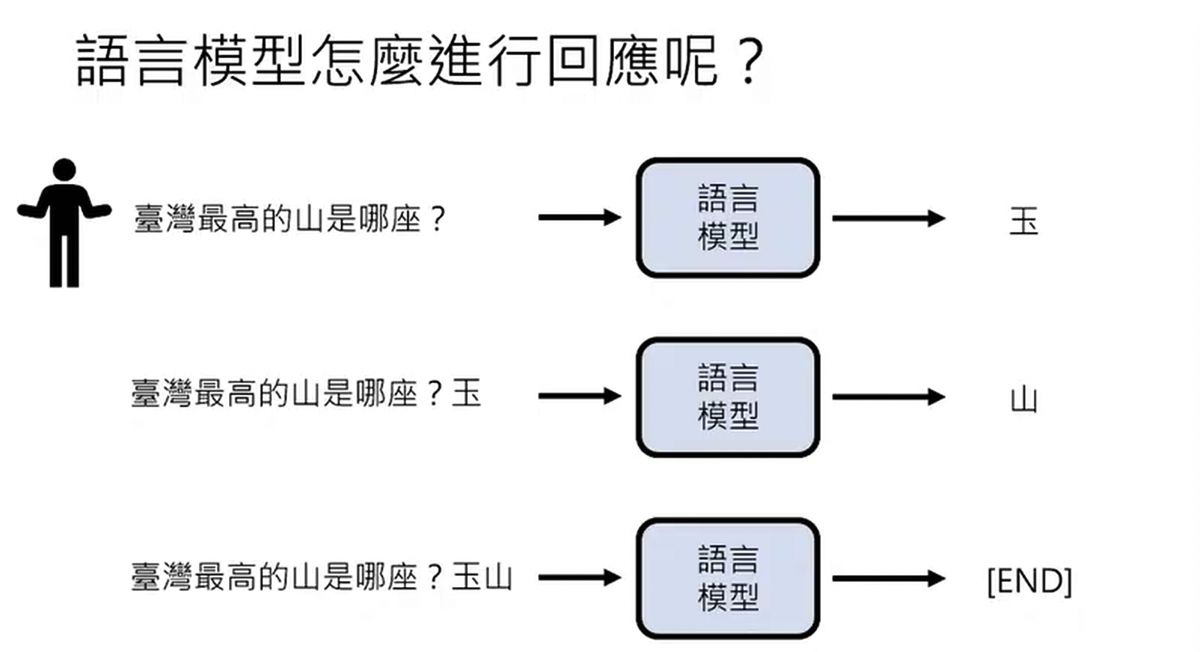
台湾最高的山是哪座?
→ 接出「玉」→ 把「玉」贴回去再接出「山」→ 接出结束符号。它产生的一连串符号,合起来就是语言模型的答案。
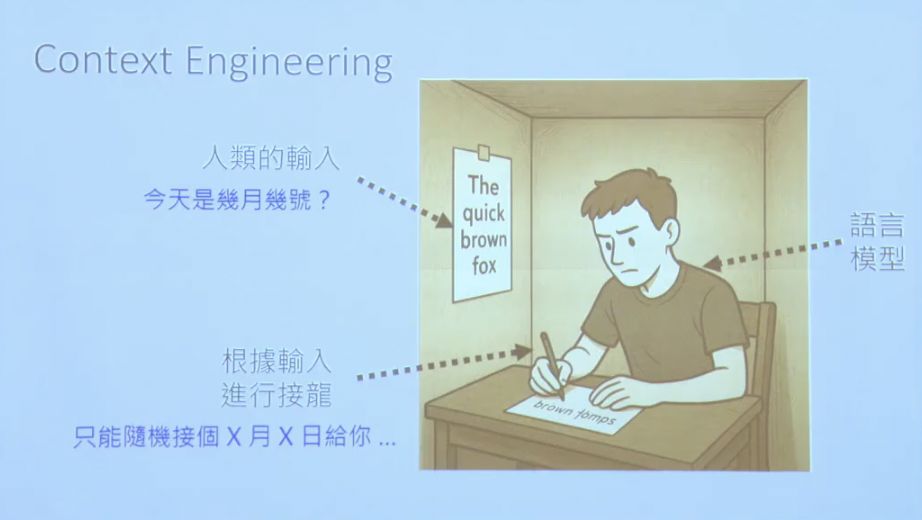
(同讲 §它不是直接"知道答案") - 小房间比喻:
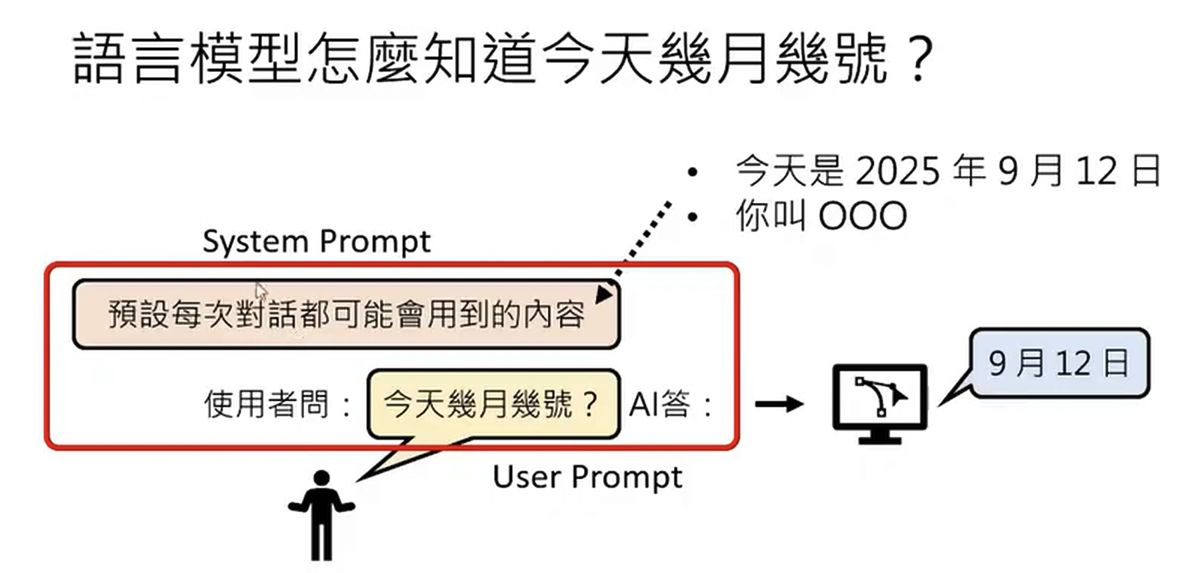
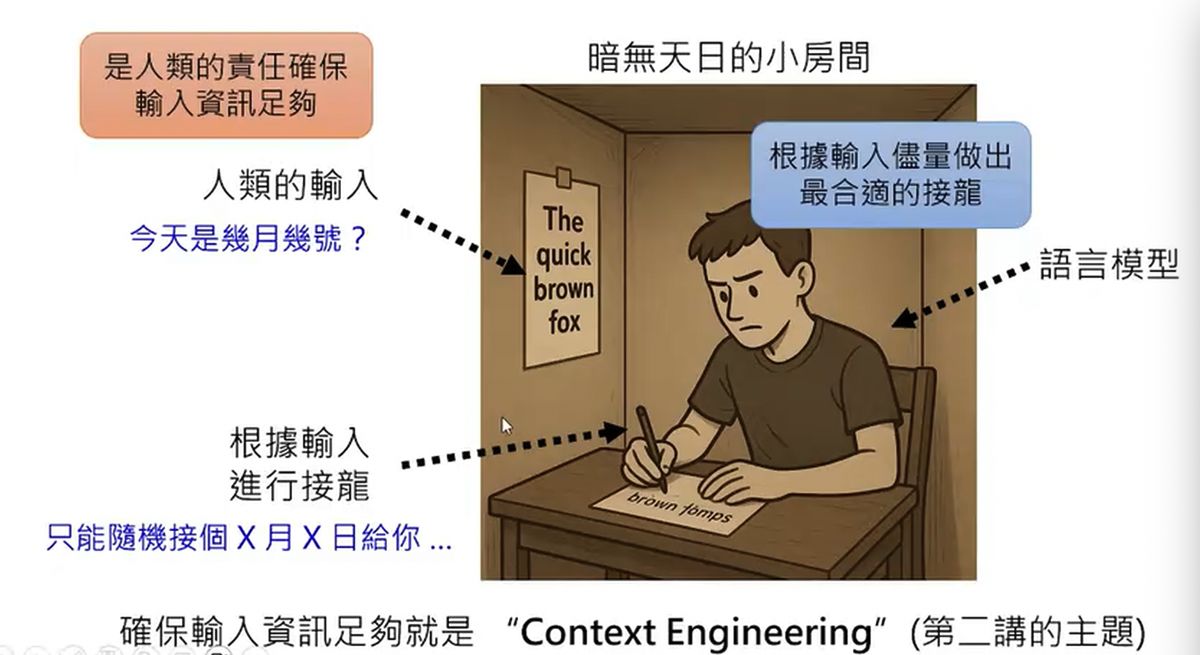
这些语言模型就像是一个关在暗无天日的小房间里面的人,他从来没有看过外面的世界。
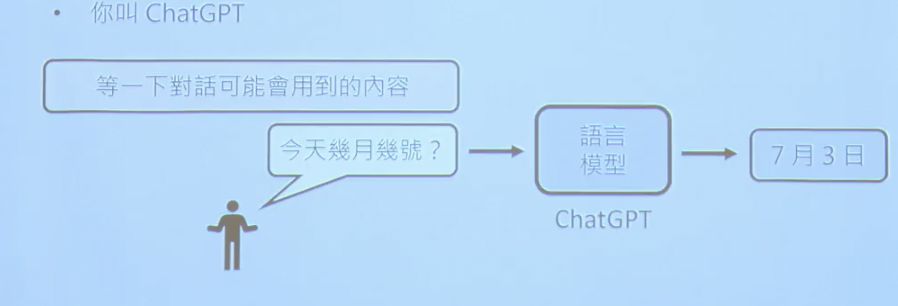
问它今天几月几号,它的房间里面又没有日历
,只能猜一个日期。(同讲 §语言模型像一个关在小房间里的人) - 两个术语:token=它每一步能选的输出单位;prompt=交给它的那段未完成的句子。(同讲 §Token 和 Prompt)
配图
常见误解
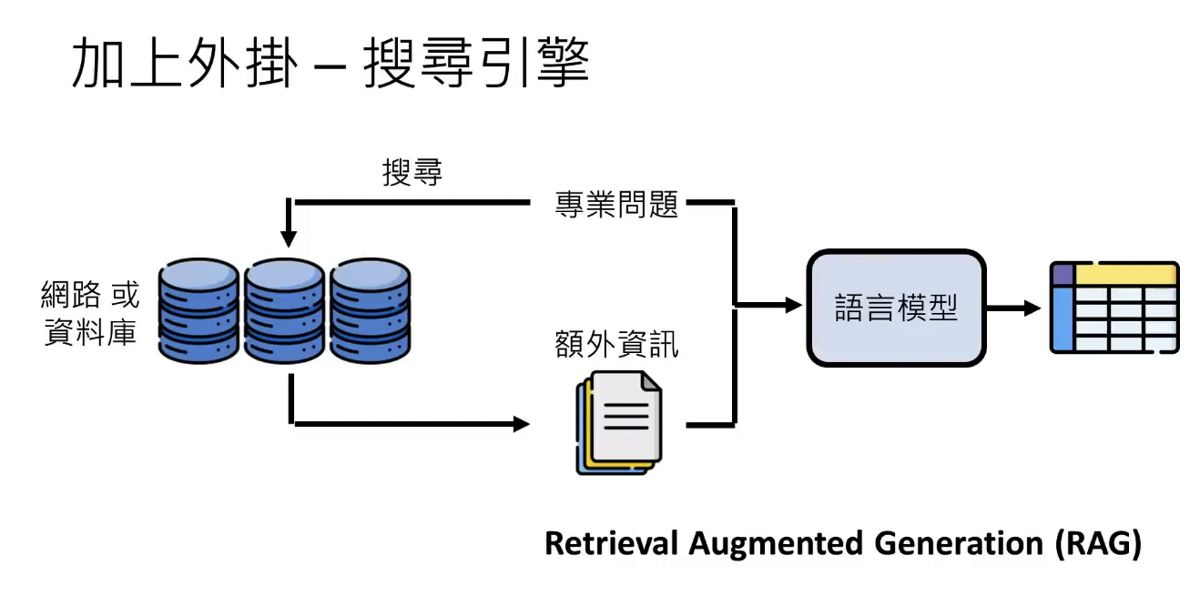
它背后有一个资料库,回答时去查
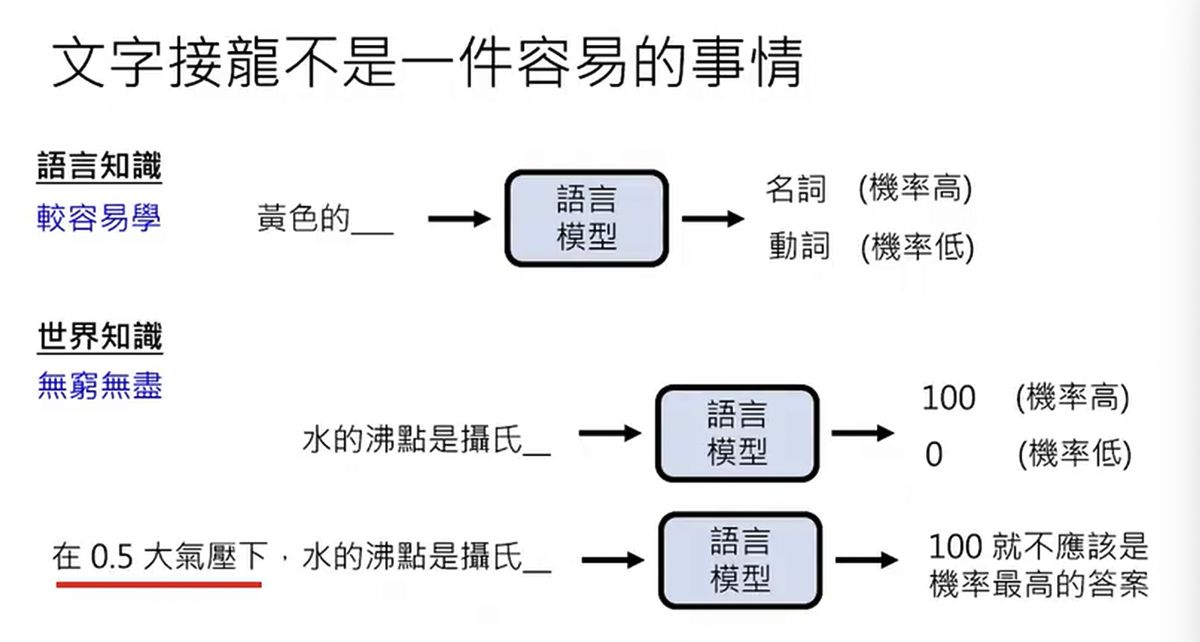
。李宏毅:这些语言模型背后,并没有所谓的资料库可言。它所产生出来的东西,都是用文字接龙的方式产生的。
(同讲 §AI 幻觉)- 「文字接龙=很笨」。见 1.3。
我的判断
- 这一条是整份报告的地基,后面每一条都从它推出来。给大众讲时,「小房间里的人」比「概率模型」好懂,建议当贯穿全篇的主比喻。
- token 不等于字:英文 Unkillable 被拆成 Un、kill、able 三个 token(《80分钟》§3)。对大众只需知道
它按块接,不按字接
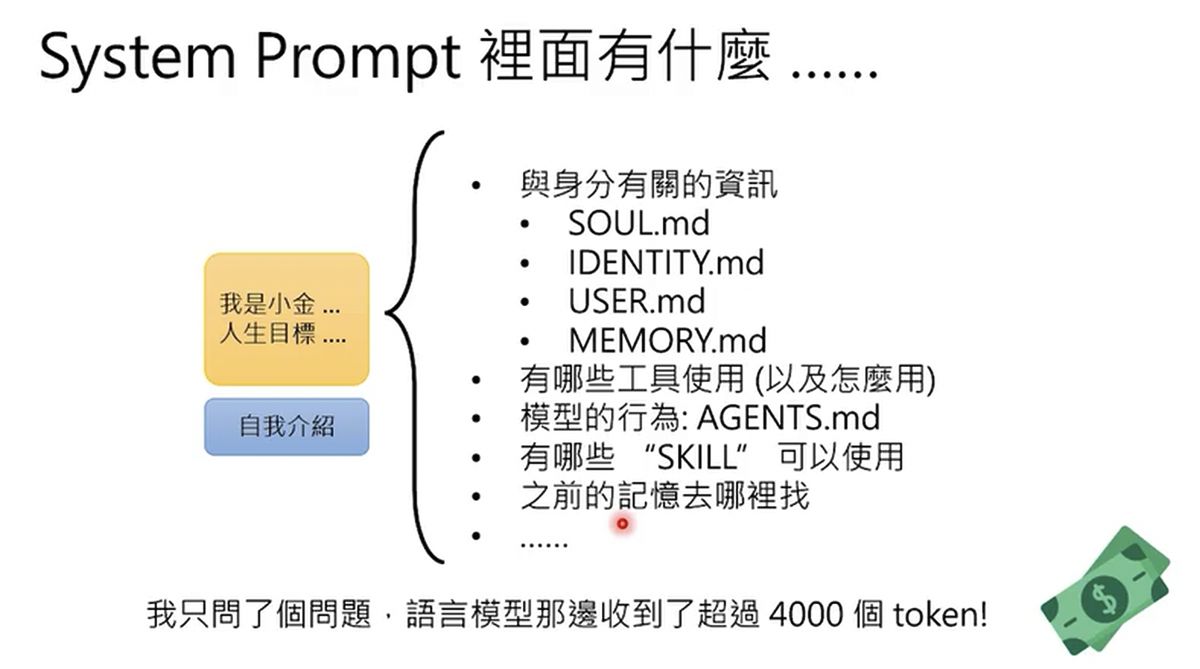
,以及计费按 token 算。